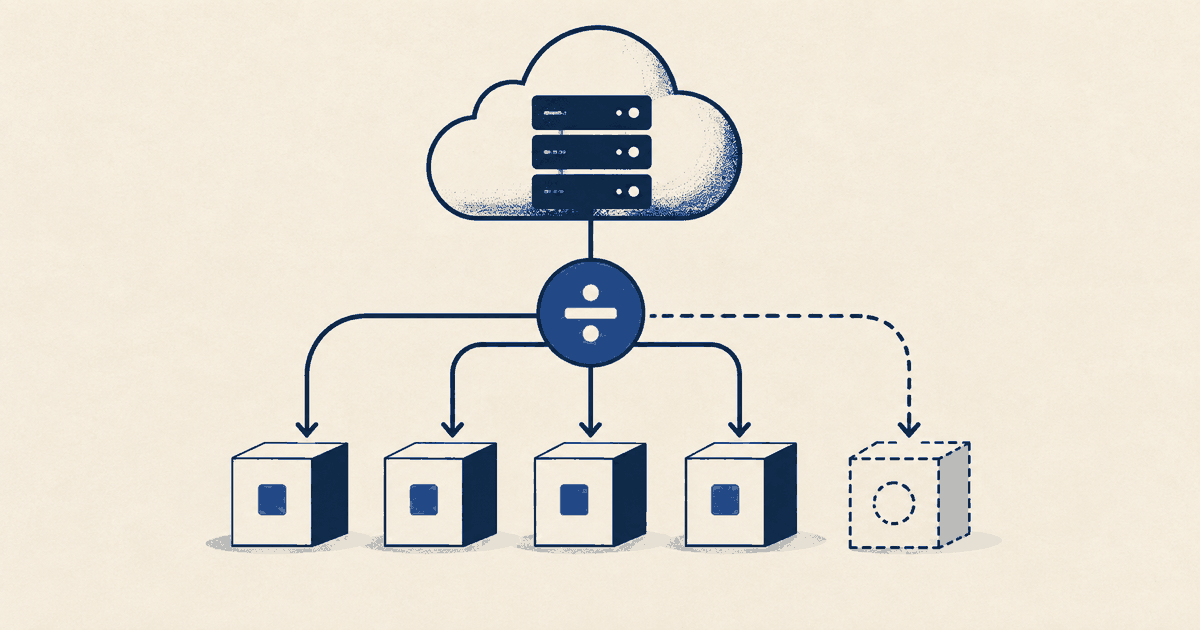
Multi-Tenant-Kosten, also die gemeinsame Infrastruktur einer mandantenfähigen SaaS, verteilen Sie fair, wenn jede geteilte Komponente nach dem Schlüssel aufgeteilt wird, der ihre Kosten tatsächlich treibt: Rechenzeit für Cluster, Speicherbelegung für Datenbanken, Nachrichten für Queues, Ingest-Volumen für Observability. Was keinen messbaren Treiber hat, bleibt zentral, und was niemand zuordnen kann, bleibt sichtbar. Danach ergibt die Summe aller Anteile auf den Cent den Quellbetrag. Wie aus diesen Anteilen eine Kennzahl pro Kunde wird, beschreibt der Leitfaden zu Cloud-Kosten pro Kunde. Hier geht es um die Verteilung selbst, auf Mandanten ebenso wie auf Produktlinien.
Was das Tenancy-Modell für die Verteilung bedeutet
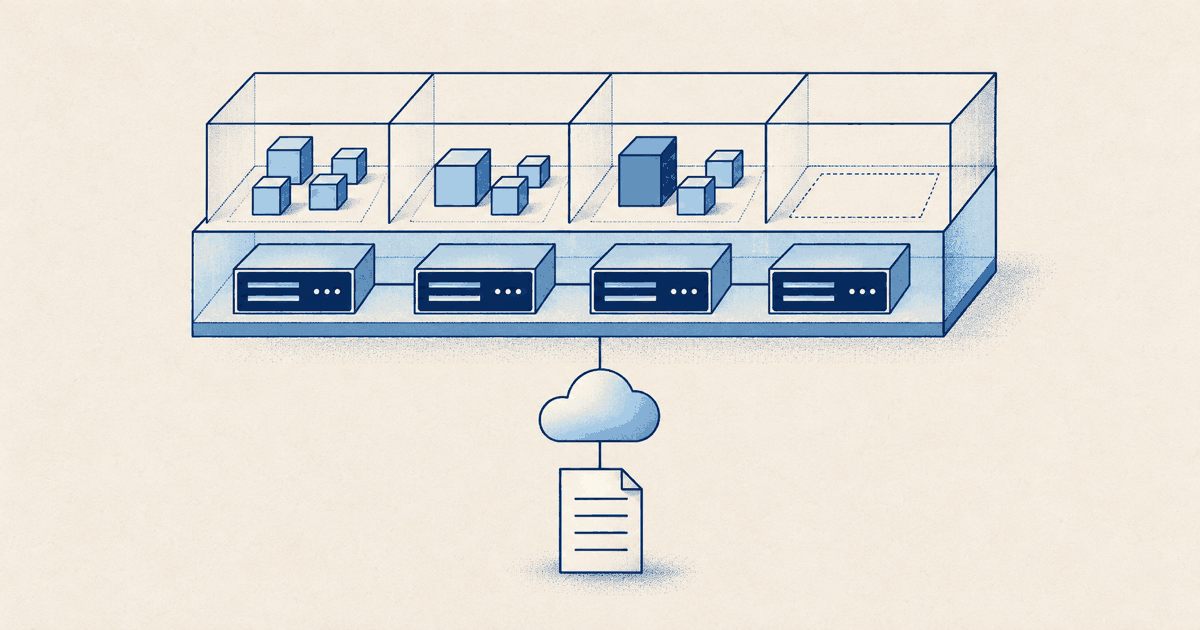
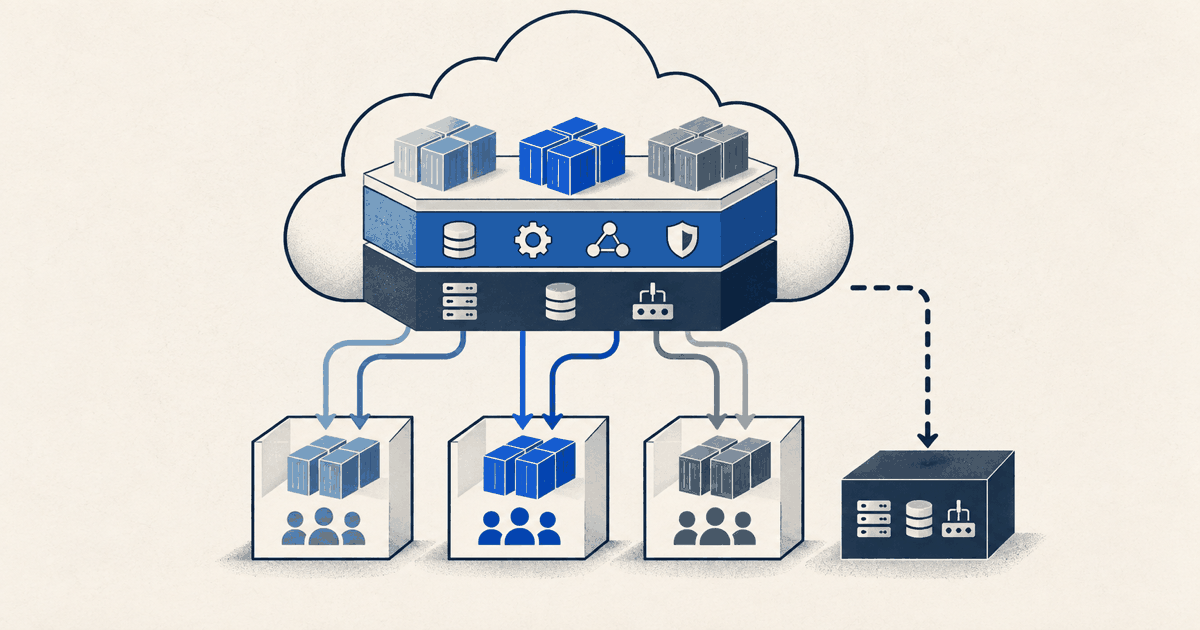
Die AWS Well-Architected SaaS Lens unterscheidet drei Muster. Im Silo-Modell erhalten Mandanten dedizierte Ressourcen, im Pool-Modell teilen sie Ressourcen, und das Bridge-Modell mischt beides, etwa mit einzelnen Microservices im Silo und anderen im Pool. Die AWS Guidance for Multi-Tenant Architectures fasst den Zielkonflikt so: Das Silo-Modell bietet die stärkste Isolation bei den höchsten Kosten, das Pool-Modell die schwächste Isolation bei den niedrigsten Kosten. Für die Verteilung folgt daraus:
| Modell | Woher der Mandantenbezug kommt | Typische Lücke |
|---|---|---|
| Silo | Konto, Abonnement, Projekt oder Tag je Mandant | Gemeinsame Identität, Onboarding und Betrieb fehlen in der Mandantensumme |
| Pool | Nur aus Anwendungsmetriken, denn eine Ressource dient allen | Ohne Messung je Mandant bleibt nur eine Schätzung |
| Bridge | Je Komponente verschieden, etwa gemeinsame Anwendung und eigenes Schema je Mandant in einer Datenbankinstanz | Ein einziger Schlüssel für alles verzerrt die gemischten Komponenten |
Die SaaS Lens weist ausdrücklich darauf hin, dass feinkörnige Verbrauchsmessung im Pool viele übliche Zuordnungswege wie Tagging ausschließt. Auch Leerlauf verhält sich je Modell anders. Im Silo hat er einen Eigentümer: Die ungenutzte Kapazität einer dedizierten Datenbank gehört dem Mandanten, für den sie läuft. Im Pool ist Leerlauf eine gemeinsame Entscheidung über Reserve und Mindestgröße und gehört nicht automatisch dem größten Mandanten.
Verteilungsschlüssel je Komponente
Die SaaS Lens empfiehlt, Verbrauch dort zu messen, wo der Großteil der Rechnung entsteht. Beginnen Sie mit den Komponenten, die den größten Kostenanteil tragen, und nutzen Sie für den Rest einen benannten Ersatzschlüssel.
| Komponente | Schlüssel | Datenquelle | Achtung |
|---|---|---|---|
| Kubernetes- oder ECS-Cluster | CPU- und Speicheranteil je Namespace oder Task | AWS Split Cost Allocation Data, GKE Cost Allocation, AKS Cost Analysis | Leerlauf und Systemreserve getrennt ausweisen |
| Geteilte relationale Datenbank | Speicherbelegung je Mandant, bei Lastunterschieden zusätzlich Abfragezeit | PostgreSQL pg_total_relation_size je Tabelle, summiert je Schema; Abfragezeit nur mit Mandantenkontext aus der Anwendung | Speicher allein unterschätzt rechenintensive Mandanten |
| Objektspeicher | GB-Monate je Bucket oder Präfix | Tag am Bucket; sonst S3 Inventory mit Objektgröße, filterbar nach Präfix | Requests und Datentransfer gesondert betrachten |
| Queue, Streaming | Nachrichten oder Bytes je Mandant | Zähler im Producer | Wiederholte Zustellungen mitzählen |
| Observability | Ingest-Volumen je Mandant | Feld tenant_id in Logs und Traces, aggregiert im eigenen Backend | Plattform-Logs ohne Mandant bleiben zentral |
| API-Gateway, Load Balancer | Anfragen je Mandant | Zugriffslogs mit Mandanten-ID | Eine Anfrage sagt nichts über ihren Rechenaufwand |
| Kontrollebene, CI, Sicherheitswerkzeuge | Kein Verbrauchsbezug | Policy-Entscheidung | Zentral tragen oder fest verteilen und so benennen |
Für Produktlinien gilt dasselbe Raster. Statt nach Mandanten-ID messen Sie den Schlüssel je Produktlinie, etwa Anfragen je API-Pfad oder Speicher je Schema. Nutzt ein Mandant mehrere Produktlinien, verteilen Sie nicht zweimal: Legen Sie fest, ob Mandant oder Produktlinie die führende Verteilung ist, und leiten Sie die andere Sicht daraus ab.
Container-Cluster: was AWS, Google Cloud und Azure liefern
Für geteilte Cluster müssen Sie den Schlüssel nicht selbst messen. Alle drei Anbieter liefern Kosten auf Namespace-Ebene, aber mit unterschiedlicher Methode.
AWS Split Cost Allocation Data gilt für Amazon ECS, einschließlich Fargate, AWS Batch und Amazon EKS. Sie aktivieren es in der Billing and Cost Management Console unter Cost Management preferences, Abschnitt Split cost allocation data; das geht nur im Management- oder einem Einzelkonto. Für EKS wählen Sie die Messgrundlage: Resource requests, Amazon Managed Service for Prometheus (der höhere Wert aus Request und tatsächlicher Nutzung) oder Amazon CloudWatch Container Insights. Die Daten erscheinen nur in CUR und CUR 2.0, nicht im Cost Explorer, und brauchen bis zu 24 Stunden. Der FOCUS-1.2-Export von AWS bietet dafür keine Tabellenkonfiguration; welcher Export wofür taugt, klärt der Vergleich CUR 2.0 oder FOCUS. In CUR 2.0 tragen split_line_item_split_cost und split_line_item_unused_cost die Beträge je Pod oder Task. split_line_item_split_usage ist das Maximum aus konfigurierter und tatsächlicher Nutzung. Tags wie aws:eks:namespace sind standardmäßig als Kostenzuordnungs-Tags aktiv.
GKE Cost Allocation schalten Sie pro Cluster ein:
gcloud container clusters update CLUSTER_NAME --enable-cost-allocation
Der detaillierte BigQuery-Export erhält dann Labels wie k8s-namespace, k8s-workload-name und k8s-label/ mit dem Pod-Label-Schlüssel. Grundlage sind Resource Requests, nicht der Verbrauch. Leerlauf erscheint als kube:unallocated, Systemreserve als kube:system-overhead. Google füllt keine Vergangenheit nach und nennt bis zu drei Tage Verzögerung.
AKS Cost Analysis setzt den Tarif Standard oder Premium voraus und zeigt Kubernetes-Kosten nur für Enterprise Agreement und Microsoft Customer Agreement:
az aks update --resource-group RESOURCE_GROUP --name CLUSTER_NAME --enable-cost-analysis
Ausgewiesen werden Idle, Service, System und Unallocated charges je Namespace und Asset.
Ein Namespace je Mandant macht diese Daten direkt nutzbar. Teilen sich Mandanten einen Namespace, liefern die Anbieter nur den Anteil des Namespace; die weitere Aufteilung kommt wieder aus Ihrer Anwendung.
Summen exakt halten
Eine Verteilung ist erst belastbar, wenn sie kein Geld erzeugt und keines verliert:
- Eine Kostenbasis. Verteilen Sie amortisierte oder fakturierte Kosten, nie beides gemischt.
split_line_item_split_costenthält amortisierte Vorauszahlungen für Reservierungen und Savings Plans;split_line_item_net_split_costberücksichtigt zusätzlich alle Rabatte. - Je Komponente und Monat abschließen. Summe der Anteile plus Leerlauf plus nicht Zugeordnetes ergibt den Quellbetrag der Komponente.
- Erst am Ende runden. Rechnen Sie mit voller Genauigkeit und runden Sie einmal je Komponente nach der Methode des größten Rests: alle Anteile auf den Cent abrunden, die Differenz zur Quellsumme bestimmen, die fehlenden Cent einzeln an die Mandanten mit den größten abgeschnittenen Resten vergeben. Die Summe stimmt exakt, und das Ergebnis ist reproduzierbar.
- Leerlauf benennen. AWS verteilt
split_line_item_unused_costproportional zur Split-Nutzung auf Pods; GKE und AKS weisen Leerlauf als eigene Position aus. Summieren Sie ihn getrennt. Ob er später nach Nutzung verteilt wird, ist eine dokumentierte Entscheidung, keine Voreinstellung. - Regeländerungen getrennt zeigen. Ändern Sie einen Schlüssel, rechnen Sie den Vormonat mit der neuen Regel nach und weisen Sie den Regeleffekt getrennt vom Verbrauch aus.
Die Kostenzuordnungsregeln in Microsoft Cost Management verteilen Kosten zwischen Abonnements, Ressourcengruppen oder Tags, allerdings nur für Enterprise Agreement und Microsoft Customer Agreement, ohne Käufe wie Reservierungen und Savings Plans und ohne Wirkung auf die Rechnung. Die Prozentsätze werden beim Anlegen vorbelegt, gleichmäßig oder nach Gesamt-, Compute-, Speicher- oder Netzwerkkosten der Ziele, und ändern sich danach nur durch manuelle Aktualisierung. Ein Schlüssel, der der Nutzung folgen soll, braucht also einen festen Termin zur Aktualisierung. In Exporten markiert die Spalte costAllocationRuleName die umverteilten Zeilen; für den Rechnungsabgleich filtern Sie sie heraus.
Prüfliste vor der ersten Veröffentlichung
- Jede Komponente hat einen benannten Schlüssel, eine Datenquelle und eine verantwortliche Person.
- Schlüssel und Kosten beziehen sich auf denselben Monat in UTC.
- Interne und Test-Mandanten sind im Nenner enthalten.
- Die Summenprobe schließt je Komponente auf den Cent.
- Leerlauf und nicht Zugeordnetes stehen als eigene Zeilen im Bericht.
- Ein Mandant mit mehr gemessener Nutzung trägt unter der Regel mehr Kosten.
- Finance kann die Regel ohne Engineering nachrechnen.
Was Costfluent dabei abdeckt
In Costfluent ordnen Regeln Kosten nach Konto oder Abonnement, Ressourcengruppe, Ressourcenname oder Tag einem Segment zu, das Team, Produkt und Kostenstelle benennt. Als geteilt markierte Kosten verteilt Costfluent im Verhältnis der direkten Kosten der Segmente im selben Zeitraum, sodass die Summe exakt bleibt; was keine Regel trifft, steht auf einer Zeile für nicht zugeordnete Kosten. Eine geänderte Regel rechnet auch zurückliegende Monate neu. Für Kubernetes zeigt der Cluster-Agent Kosten je Namespace und den Leerlauf getrennt, wie der Beitrag zu Kubernetes-Clusterkosten beschreibt. Nutzungsschlüssel aus Ihrer Anwendung, etwa Anfragen oder Speicher je Mandant, nimmt Costfluent nicht auf; diese Verteilung rechnen Sie außerhalb. Mehr unter Kostenzuordnung und im Glossar unter geteilte Kosten.
Quellen und Methode
Geprüft am 10. Oktober 2026: AWS SaaS Lens: Silo, Pool and Bridge Models, AWS SaaS Lens: Expenditure awareness, AWS Guidance for Multi-Tenant Architectures, AWS: Understanding split cost allocation data, AWS: Enabling split cost allocation data, AWS: CUR 2.0 split line item columns, AWS: FOCUS 1.2 with AWS columns, Google Cloud: GKE cost allocation, Microsoft: AKS cost analysis, Microsoft: Allocate Azure costs, PostgreSQL 18: Database Object Size Functions, Amazon S3 Inventory und FinOps Foundation: Allocation. Schlüsseltabelle, Rundungsmethode und Prüfliste sind Costfluent-Empfehlungen.